클라우드플레어에서 서울 서버로, 관리 화면이 420ms에서 6ms가 되기까지
관리 화면이 느린 원인은 코드가 아니라 거리였다. 한국 요청이 미국 LA 엣지를 돌고, Hyperdrive 연결은 5ms와 80ms를 오갔다. API만 GCP 서울 VM으로 옮기고 요청을 묶어 420ms를 6ms로 줄인 과정을 정리했다.
빠르다는 건 결국 거리의 문제였다
웹 서비스 속도를 이야기할 때 보통 코드나 쿼리를 먼저 본다. 이번에 겪어 보니 순서가 반대였다. 요청이 어디를 거쳐서 오는지부터 봐야 했다.
직접 운영하는 서비스의 관리 화면이 예전 카페24에서 돌던 시절처럼 빠릿하지 않았다. 버튼을 누르면 한 박자 늦게 반응하고, 주문관리 첫 화면은 1초 가까이 기다려야 떴다. 이 글은 그 원인을 찾고, API를 GCP 서울 VM으로 옮기기까지의 기록이다.
클라우드플레어를 고른 이유
처음 클라우드플레어로 간 건 장점이 분명해서였다.
서버를 직접 관리하지 않아도 된다. Worker에 코드를 올리면 배포가 끝나고, 서버가 죽거나 패치를 해야 하는 걱정이 없다. 1인 회사 입장에서 이건 꽤 큰 이유다.
필요한 게 한곳에 다 있다. DNS, 정적 파일, 파일 저장소(R2), 메일, 정해진 시간마다 도는 크론 작업까지 한 계정 안에서 해결된다. 주문 수집이나 송장 전송 같은 주기 작업을 따로 서버 없이 돌릴 수 있다는 게 편했다.
DB 연결도 도와준다. Hyperdrive라는 기능이 Worker와 외부 DB 사이에서 연결을 유지해 주고, Placement 설정으로 Worker가 DB 근처(서울)에서 실행되게 할 수도 있다. 서류상으로는 빠를 수밖에 없는 구조였다.
DB는 D1에서 PlanetScale로 먼저 옮겨 두었다
처음 DB는 클라우드플레어의 D1이었다. 설정 없이 Worker에 바로 붙고, 따로 돈 들 일도 거의 없었다. 시작하기엔 이만큼 편한 게 없다.
그런데 D1은 SQLite 기반이고 데이터베이스 하나에 담을 수 있는 크기가 정해져 있다. 주문 데이터는 매일 쌓이고, 거래처가 늘면 동시에 쓰는 사람도 는다. 지금 당장은 문제가 없어도 언젠가는 옮겨야 하는 구조였다.
옮길 거라면 데이터가 적을 때 옮기는 게 가장 싸다. 그래서 차후 확장성을 보고 미리 PlanetScale(PostgreSQL)로 옮겼고, 리전은 GCP 서울로 잡았다. 이 결정이 나중에 꽤 큰 도움이 됐다.
그런데 체감은 느렸다
같은 API를 한 번 부르는 데 약 420ms가 걸렸다. 새 연결로 첫 요청을 보내면 950ms 정도였다. 주문관리 첫 화면은 요청 세 번을 차례로 보내느라 750~820ms가 걸렸고, 대시보드는 요청 11개가 나가는데 가장 느린 게 563ms였다.
하나씩 보면 못 쓸 수준은 아니다. 하지만 관리 화면은 하루 종일 클릭하는 화면이다. 매번 반 박자씩 늦으면 일하는 리듬이 깨진다.
원인을 재는 방법부터 정했다
감으로 고치면 엉뚱한 데를 손보게 된다. 그래서 구간별로 시간을 쪼개서 재기로 했다.
먼저 로그인된 브라우저에서 같은 API를 fetch로 반복 호출하면서 응답 헤더를 봤다. Server-Timing 헤더에 서버 안에서 걸린 시간과 DB 시간, 쿼리 수를 담아 두었고, cf-ray로 어느 엣지를 거쳤는지, cf-placement로 Worker가 어디서 실행됐는지를 확인했다. 서버 안 시간은 79~326ms였는데 체감은 370~820ms였다. 서버 밖에서 새는 시간이 더 많았다는 뜻이다.
다음은 네트워크 구간이다. curl의 -w 옵션으로 연결, TLS, 첫 바이트까지 시간을 따로 찍고, /cdn-cgi/trace로 어느 데이터센터에 붙었는지 확인했다.
DB 자체도 따로 쟀다. 로컬에서 DB에 직접 붙어 SELECT 1 왕복 시간을 보고, 느려 보이는 쿼리는 EXPLAIN ANALYZE로 실행 계획을 봤다.
연결 방식 비교는 임시 Worker를 두 개 만들어서 했다. 하나는 서울 배치, 하나는 배치 없이 두고 Hyperdrive, 직접 연결, 캐시를 끈 Hyperdrive를 같은 조건에서 재고 바로 지웠다.
첫 번째 원인, 한국 요청이 미국으로 간다
가장 큰 원인은 엉뚱한 곳에 있었다.
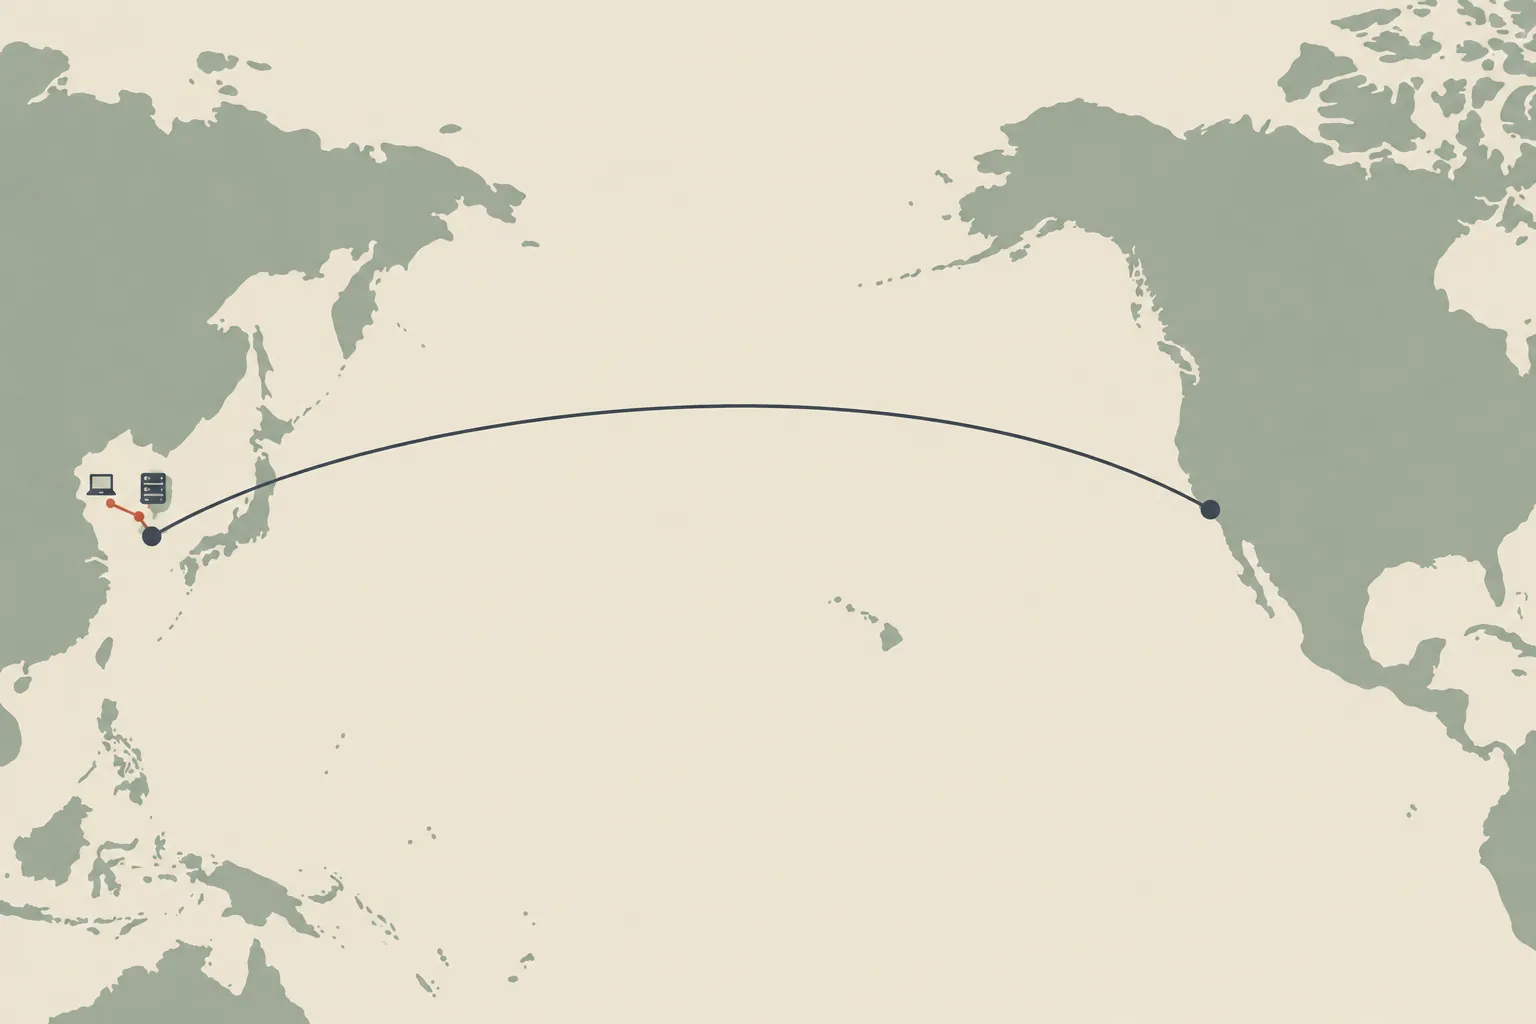
/cdn-cgi/trace를 찍어 보니 colo=LAX가 나왔다. 한국에서 보낸 요청이 미국 LA 엣지로 들어가고 있었다. 연결만 150ms. 같은 PC에서 카페24에 붙으면 18ms였다.
클라우드플레어 일반 요금제는 한국 통신사와의 경로 사정 때문에 한국 요청을 해외 엣지로 보내는 경우가 많다. 이건 코드로도, Placement 설정으로도 바꿀 수 없는 부분이다. 요청 하나마다 왕복으로 300ms 가까이 길에서 버리고 있었다.
혹시나 해서 GCP 서울 VM에서도 붙어 봤다. 서울이 아니라 오사카(KIX)로 붙었다. 연결 36ms. 그래서 서울 VM을 클라우드플레어 앞에 두고 중계하는 방법도 효과가 어중간하다는 걸 알았다.
두 번째 원인, 같은 쿼리가 5ms이거나 80ms이거나
Placement는 제대로 동작하고 있었다. 응답 헤더에 remote-ICN이 찍혔으니 Worker는 서울에서 돌고 있었다. 그런데도 쿼리 하나에 80ms가 걸리는 경우가 많았다. 같은 PC에서 DB에 직접 붙으면 5ms인데.
임시 Worker로 재 보니 패턴이 보였다. Hyperdrive가 연결을 어디로 잡느냐에 따라, 그 연결로 나가는 쿼리가 전부 5~10ms이거나 전부 76~80ms였다. 중간이 없었다. 그리고 그건 우리 쪽에서 고를 수 없었다.
캐시 문제인가 싶어 쿼리 캐시를 끈 설정도 쟀는데 똑같이 튀었다. Hyperdrive를 빼고 DB에 직접 연결하면 오히려 40ms로 더 느렸다. 연결 방식 자체는 Hyperdrive가 맞았다. 다만 그 안에서 뽑기를 하고 있었던 거다.
세 번째 원인, 느리니까 쌓인 우회들
요청 하나가 300ms를 넘으니 화면 쪽에서 이걸 감추려는 코드가 하나둘 늘어 있었다.
주문 목록은 앞 100건을 먼저 받고 나머지를 500건씩 이어 받았다. 화면 틀을 먼저 그리고 조각조각 채웠다. 마우스를 올리면 다음 화면 데이터를 미리 받았다. 다 그럴듯한 최적화였지만, 요청이 느린 환경에서는 요청 수가 곧 대기 시간이었다. 우회가 요청을 더 늘리고 있었다.
서버 안도 비슷했다. 여러 쿼리를 묶어 보내는 batch가 실제로는 하나씩 차례로 실행되고 있었다. 메뉴 배지 19개, 대시보드 21개 쿼리가 줄을 서서 기다렸다.
개별로 느린 쿼리도 두 개 있었다. 최근 7일 추이는 원본 주문을 매번 COUNT(DISTINCT)로 세느라 38ms, 출고 지연은 시간 비교 함수가 줄마다 계산되느라 20ms였다. 나머지 쿼리는 대부분 1ms 이하였다. 문제는 쿼리가 아니라 왕복이었다.
쉬웠던 부분, DB는 이미 서울에 있었다
다행인 건 DB가 이미 GCP 서울에 있었다는 점이다. 확장성을 보고 D1에서 PlanetScale로 옮겨 둔 덕을 여기서 봤다. D1에 그대로 있었다면 DB까지 같이 옮겨야 했다.
서울 VM 후보를 하나 띄워서 재 봤다. PC에서 VM까지 15ms, VM에서 DB까지 2ms. 길만 바꾸면 되는 문제라는 게 숫자로 확인됐다. 남은 숙제는 클라우드플레어를 통째로 버리지 않고 어떻게 API만 옮기느냐였다.
해결 1, API만 서울에서 돌린다
구조를 이렇게 바꿨다. 한국 사용자가 API 전용 하위 도메인(api.)으로 바로 가고, 그게 GCP 서울 VM이다. VM에서 DB까지는 같은 서울 안이다.
VM은 e2-standard-2(vCPU 2, 메모리 8GB) 한 대에 Debian, Node 22, Caddy를 올렸다. Caddy가 인증서를 알아서 받아 준다.
여기서 중요한 게 하나 있다. API 하위 도메인의 DNS는 클라우드플레어 프록시를 끄고 DNS only로 둬야 한다. 프록시를 켜면 다시 LAX를 거친다.
코드는 새로 짜지 않았다. Worker에서 쓰던 요청 처리 함수를 Node에서 그대로 실행하는 얇은 서버를 하나 만들고, 빌드하면 파일 하나로 나오게 했다. 같은 커밋에서 Worker와 서울 서버가 같이 배포된다.
DB 연결은 요청마다 새로 맺지 않고 상시 연결 풀을 둔다. Worker에서는 할 수 없던 일이다.
클라우드플레어에 남긴 것
전부 옮기지는 않았다. 클라우드플레어가 잘하는 건 그대로 뒀다.
로그인과 로그아웃, 결제, 주문 수집과 송장 전송 같은 크론 작업, 소개 페이지와 정적 파일, PC 프로그램과 확장 프로그램이 부르는 API는 Worker에 남았다. 파일 저장소(R2)와 메일은 서울 서버가 Worker의 내부 통로를 통해 쓴다. 내부 통로는 비밀값이 맞지 않으면 아예 없는 주소처럼 응답한다.
결국 속도가 중요한 관리 화면 조회만 서울로 보내고, 나머지는 클라우드플레어의 편함을 그대로 누리는 구성이 됐다.
해결 2, 서울이 안 되면 Worker로
서버가 하나 늘면 장애 지점도 하나 는다. 그래서 관리 화면이 서울을 먼저 부르고, 연결이 안 되거나 502·503이 나면 기존 Worker로 돌아가게 했다. 한 번 실패하면 1분 동안은 Worker만 쓴다.
저장이나 변경 요청은 조심해야 했다. 서버가 받았는지 모르는 상태에서 다시 보내면 두 번 저장될 수 있다. 그래서 저장·변경은 자동으로 재시도하지 않고, 조회가 한 번 성공해서 서울이 살아 있다는 걸 확인한 뒤에만 서울로 보낸다.
덕분에 서울 서버가 멈춰도 관리 화면은 예전 속도로 계속 동작한다.
해결 3, 로그인 쿠키를 두 주소에서 같이 쓰기
옮기고 나서 바로 걸린 게 로그인이었다. 기존 쿠키는 본 사이트 주소 전용이라 API 하위 도메인으로 가지 않았다.
Worker가 로그인 응답의 쿠키를 상위 도메인 기준으로 바꿔서 내보내게 했다. 이미 로그인한 사람은 다음 요청 때 바꿔 준다.
여기서 하나 더 걸렸다. 예전 호스트 전용 쿠키와 새 쿠키가 같이 있으면 오래된 쪽이 먼저 읽혀서 로그아웃된 것처럼 보였다. 그래서 새 쿠키를 줄 때 예전 쿠키는 지운다.
두 주소는 같은 사이트로 취급되기 때문에 SameSite=Lax 쿠키가 그대로 따라간다. CORS는 본 사이트 주소 하나만 허용했다.
해결 4, 화면 하나에 요청 하나
길이 짧아졌으니 이번엔 왕복 횟수를 줄였다.
서버에 묶음 요청 주소를 하나 만들었다. 조회 주소를 최대 20개까지 받아서 서버 안에서 동시에 처리하고 한 번에 돌려준다. 각 조회는 따로 부른 것과 똑같이 로그인과 권한을 확인한다.
화면 쪽에서는 같은 순간에 나가는 조회 요청을 자동으로 묶게 했다. 화면 코드를 하나하나 고치지 않아도 모든 화면이 요청 한 번으로 바뀌었다.
그리고 느려서 넣었던 우회들을 걷어냈다. 앞 100건 먼저 받기, 이어 받기, 마우스 올릴 때 미리 받기를 전부 뺐다. 대시보드는 판매 분석까지 한 번에 받아 한 번에 그린다. 빨라지고 나니 오히려 단순한 코드가 더 빨랐다.
해결 5, 쿼리를 모으고 요약 테이블로
서버 안에서도 같은 일을 했다.
메뉴 배지 쿼리 19개는 2개로 줄여 동시에 실행한다. 대시보드의 현재 상태 숫자들, 단계별 주문 수나 문의, 오늘 수집과 출고, 출고 지연 같은 것들은 쿼리 하나로 모았다.
느렸던 7일 추이와 오늘 매출, 판매 분석은 원본 주문을 매번 세지 않고 일별 요약 테이블에서 읽는다. 요약은 10분마다 바뀐 날만 다시 계산한다. 숫자가 최대 10분 늦게 반영되는 대신 화면은 바로 뜬다. 관리 화면 대시보드에서는 충분히 받아들일 수 있는 교환이었다.
출고 지연 쿼리는 시간 계산을 DB에 맡기지 않고 기준 시각을 값으로 넘겨서 인덱스를 타게 했다.
서울 서버의 Caddy에 zstd·gzip 압축을 켰다. 대시보드 묶음 응답이 27KB에서 7.6KB로, 주문 목록이 635KB에서 41KB로 줄었다. Worker 쪽은 클라우드플레어가 원래 알아서 해 주던 부분이다.
예상 못 한 벽, DB 연결 한도
다 끝났다고 생각했을 때 새 연결이 거부되기 시작했다. remaining connection slots are reserved라는 에러였다.
PlanetScale의 최대 연결 수는 25개인데, 관리자용 3개를 빼면 22개가 남는다. 거기서 PlanetScale 자체 연결이 4개쯤 쓴다. 처음엔 Hyperdrive 15개에 서울 풀 10개를 잡았으니 한도를 넘을 수밖에 없었다.
Hyperdrive 연결 한도를 10개로, 서울 풀을 4개로 줄였다. 지금 합계가 19개 정도다. 서울 4개로도 초당 수백 쿼리는 충분히 처리한다.
PgBouncer도 시험해 봤다. 쿼리, 트랜잭션 모두 문제없이 동작했지만 PgBouncer가 뒤에서 실제 DB 연결을 20개 가까이 열어서 같은 한도를 채웠다. 설정은 PlanetScale 쪽이라 바꿀 수 없었고, 연결을 놓는 데 10분쯤 걸렸다. 그래서 쓰지 않기로 했다. 요금제를 올리는 건 DB 자원이 실제로 찰 때 생각해도 늦지 않다. 확장성을 보고 옮긴 DB라, 그때가 와도 요금제만 올리면 된다.
결과
같은 API 한 번(연결 유지 상태)은 약 420ms에서 약 6ms가 됐다. 새 연결로 첫 요청은 약 950ms에서 약 50ms. 주문관리 첫 화면은 요청 세 번을 차례로 보내던 게 묶음 요청 한 번이 됐고, 대시보드는 요청 11개에서 로그인 확인 21ms와 묶음 요청 한 번으로 줄었다. 메뉴 배지 쿼리는 19개에서 1개가 됐다.
숫자보다 와닿는 건 클릭했을 때 그냥 바로 뜬다는 점이다. 카페24 쓰던 때 느낌이 돌아왔다.
클라우드플레어의 장점과 단점, 써 보고 나서
장점은 여전히 크다. 서버 관리 없이 배포가 끝나고, DNS부터 파일 저장소, 메일, 크론까지 한곳에서 해결된다. 서버가 죽어도 대신 받아 줄 자리가 있다는 것도 이번에 그대로 써먹었다. 1인 개발자가 운영 부담 없이 서비스를 굴리기엔 이만한 게 드물다.
단점은 한국 사용자에게 특히 크게 온다. 일반 요금제에서는 한국 요청이 해외 엣지로 갈 수 있고, 이건 코드로 해결할 수 없다. Hyperdrive 같은 중간 계층은 편하지만 그 안에서 어떤 연결을 잡는지는 고를 수 없어서, 같은 쿼리가 5ms와 80ms 사이를 오갔다. 그리고 Worker 환경에서는 상시 DB 연결 풀 같은 걸 마음대로 둘 수 없다.
정리하면 클라우드플레어는 전 세계에 흩어진 사용자에게 정적 파일과 가벼운 API를 뿌리기엔 좋고, 한국 사용자만 쓰는 DB 중심 관리 화면에는 길이 너무 길었다.
회고
코드를 빠르게 만드는 게 목표는 아니었다. 실제로 쿼리는 대부분 1ms 이하였다.
처음엔 느린 걸 화면 쪽 기술로 덮으려고 했다. 먼저 일부만 받고, 미리 받고, 조각조각 그렸다. 그런데 그건 길이 멀다는 사실을 감추는 일이었지 줄이는 일이 아니었다. 오히려 요청을 늘려서 더 느리게 만들고 있었다.
순서가 중요했다. 요청이 어디를 거쳐 가는지 먼저 재고, 그다음 왕복 횟수를 보고, 쿼리는 맨 마지막에 봤어야 했다. 길을 바꾸고 나서 걷어낸 우회 코드들을 보면서, 측정 없이 한 최적화가 얼마나 쉽게 짐이 되는지 알게 됐다.
용어 쉽게 보기
글에 나온 용어를 개발자가 아닌 분도 읽을 수 있게 풀었다.
| 용어 | 쉬운 설명 |
|---|---|
| ms (밀리초) | 1초의 1000분의 1. 사람은 100ms 안팎부터 "늦다"고 느끼기 시작한다. |
| API | 화면이 서버에 데이터를 달라고 부르는 창구. 버튼을 누를 때마다 뒤에서 API 요청이 나간다. |
| 왕복 | 요청이 서버까지 갔다가 답을 들고 돌아오는 한 번의 여정. 길이 멀면 서버가 아무리 빨라도 왕복이 느리다. |
| 클라우드플레어 | 전 세계 곳곳에 서버를 두고 웹사이트를 대신 받아 주는 회사. DNS·보안·저장소·서버 없는 실행 환경까지 제공한다. |
| 엣지 (데이터센터) | 클라우드플레어가 도시마다 둔 서버 거점. 원래는 가장 가까운 엣지로 붙어야 빠르다. |
| colo · LAX · ICN · KIX | 엣지 위치를 공항 코드로 부르는 이름. LAX는 미국 로스앤젤레스, ICN은 인천(서울), KIX는 일본 오사카. |
| Worker | 클라우드플레어 위에서 돌아가는 작은 프로그램. 서버를 따로 빌리지 않고 코드만 올리면 실행된다. |
| Placement | Worker를 어느 지역에서 실행할지 정하는 설정. DB 가까이 두면 DB 왕복이 짧아진다. |
| Hyperdrive | Worker와 외부 DB 사이에서 연결을 미리 열어 두고 나눠 쓰게 해 주는 클라우드플레어 기능. |
| D1 | 클라우드플레어가 제공하는 간단한 DB. 설정 없이 바로 쓰기 좋지만 담을 수 있는 크기에 한도가 있다. |
| PlanetScale · PostgreSQL | PlanetScale은 DB를 대신 운영해 주는 서비스, PostgreSQL은 그 위에서 쓰는 DB 종류. 데이터와 사용자가 늘어도 키워 가기 쉽다. |
| R2 | 클라우드플레어의 파일 저장소. 이미지나 첨부 파일을 넣어 두는 창고다. |
| 크론 | 정해진 시간마다 자동으로 도는 작업. 예를 들어 10분마다 주문을 모아 오는 일. |
| GCP · VM · 리전 | GCP는 구글의 클라우드, VM은 거기서 빌린 가상 서버 한 대, 리전은 그 서버가 있는 지역(이 글에서는 서울). |
| DNS · 프록시 · DNS only | DNS는 주소를 실제 서버 위치로 바꿔 주는 전화번호부. 프록시를 켜면 클라우드플레어를 거쳐 가고, DNS only면 서버로 바로 간다. |
| TLS · 인증서 | 주소창의 자물쇠. 주고받는 내용을 암호화하는 절차와 그 신분증이다. Caddy가 인증서를 알아서 받아 온다. |
| Caddy · Node | Caddy는 요청을 받아 프로그램에 넘겨주는 웹 서버, Node는 자바스크립트 프로그램을 서버에서 돌리는 실행기. |
| 연결 풀 | DB와의 연결을 미리 몇 개 열어 두고 돌려 쓰는 방식. 매번 새로 연결하는 시간을 아낀다. |
| 연결 한도 | DB가 동시에 받아 줄 수 있는 연결 수. 넘으면 새 연결을 거부한다. |
| PgBouncer | 여러 연결을 적은 수의 DB 연결로 묶어 주는 중계 프로그램. 이번에는 오히려 연결을 더 써서 빼기로 했다. |
| 쿼리 · 인덱스 | 쿼리는 DB에 던지는 질문, 인덱스는 책 뒤의 찾아보기. 인덱스를 타면 처음부터 다 뒤지지 않는다. |
| EXPLAIN ANALYZE | 쿼리가 실제로 어떤 순서로 얼마나 걸려 실행됐는지 보여 주는 DB 명령. |
| 요약 테이블 | 매번 원본을 세지 않도록 날짜별 합계를 미리 계산해 둔 표. 숫자는 조금 늦게 반영되지만 화면은 바로 뜬다. |
| 묶음 요청 (batch) | 여러 개의 요청을 한 번에 보내고 한 번에 받는 방식. 왕복 횟수가 줄어든다. |
| 쿠키 · 상위 도메인 | 쿠키는 로그인 상태를 기억하는 작은 표. 상위 도메인 기준으로 만들면 같은 회사의 하위 주소들이 함께 쓸 수 있다. |
| SameSite · CORS | 다른 사이트가 내 로그인 정보를 함부로 쓰지 못하게 막는 브라우저 규칙들. |
| 502 · 503 | 서버가 답을 못 했다는 오류 번호. 이때는 클라우드플레어 쪽으로 자동으로 돌아간다. |
| Server-Timing | 서버가 응답에 "안에서 몇 ms 걸렸다"를 적어 보내는 칸. 서버 안과 밖의 시간을 나눠 볼 수 있다. |
| zstd · gzip | 데이터를 줄여서 보내는 압축 방식. 받는 쪽에서 원래대로 풀어 쓴다. |